受発注の検証ノート
FAX注文書の「20箱」を受注明細にするまで。試作で分かった確認のポイント
注文書に書かれた文字が読めても、そのまま受注登録できるとは限りません。「箱」を「個」に換算するには入数が必要です。品番を一文字読み違えると、商品を特定できなかったり、明細そのものを取りこぼしたりすることもあります。
今回は開発中の受発注デモで、架空の注文書を読み取ってみました。内容の違う5枚を4つの画像条件にした計20入力のうち、事前に決めた確認項目がすべて一致したのは7入力でした。うまくいった例と、確認が必要になった例を紹介します。
これは実際の顧客帳票やFAX受信画像を使った試験ではありません。今回の小規模な検証から、実務での読み取り精度や時間削減効果は判断できません。
1. 「20箱」を入力する前に、商品と入数を確認する
今回用意した注文書の一つには、次の3明細を記載しました。
| 品番・商品 | 注文書の数量 | 商品マスターの入数 | 換算後の数量 |
|---|---|---|---|
| P006 ケーブルタイ 200mm | 20箱 | 1箱10個 | 200個 |
| P008 絶縁テープ 黒 | 30個 | 1箱10個 | 30個 |
| P001 差込コネクタ 2極 | 3箱 | 1箱100個 | 300個 |
同じ「箱」でも、商品によって入数が違います。また、30個という注文は、そのまま30個として扱います。文字を読み取る処理と、商品マスターを使った換算は別の工程です。
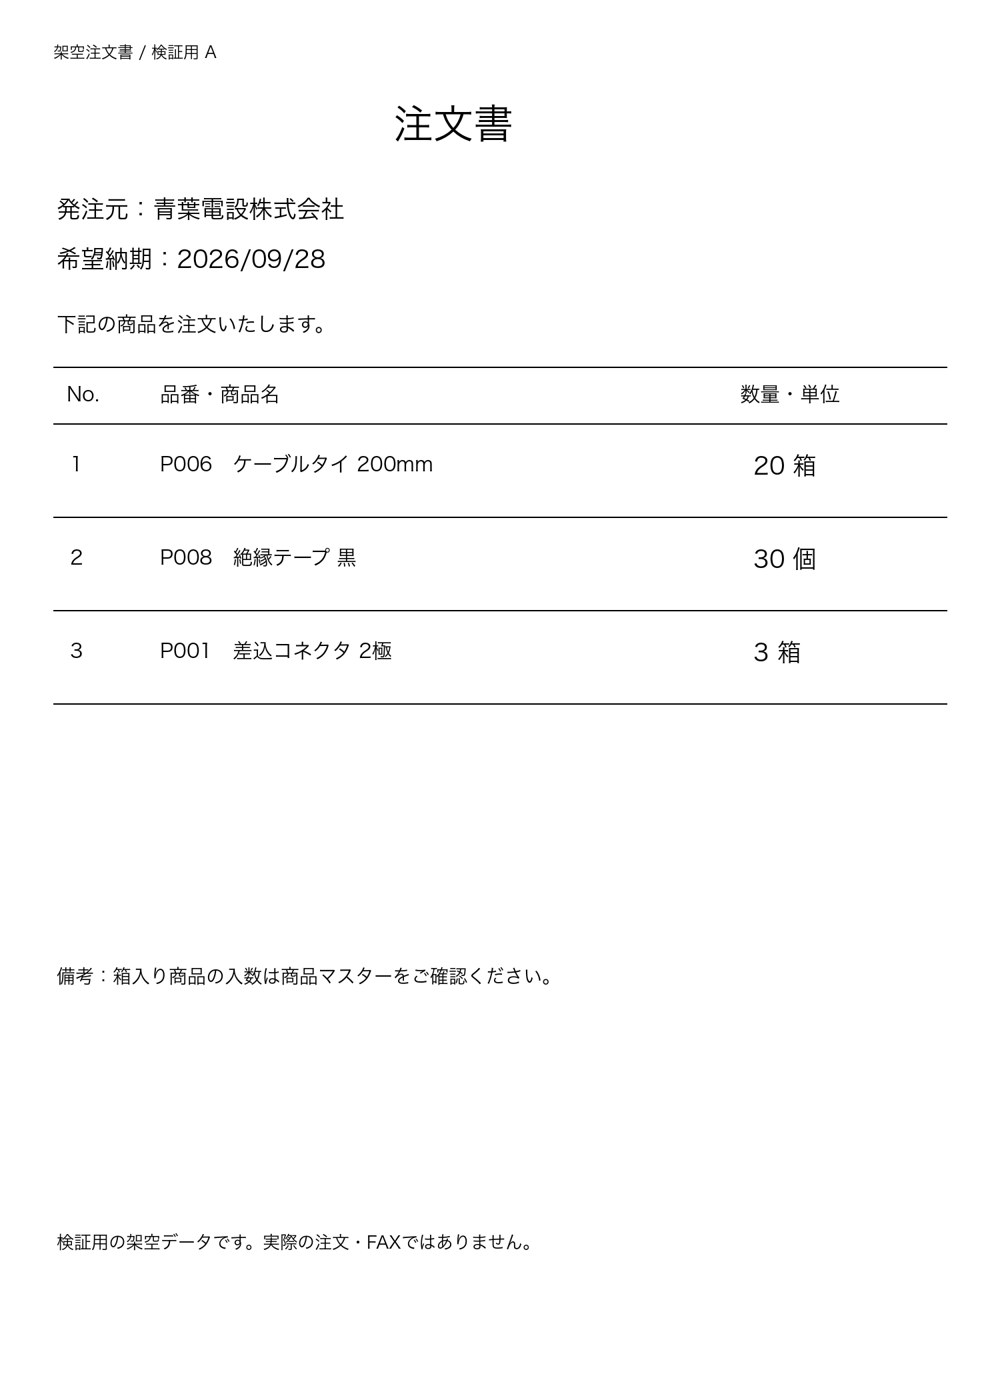
品番・商品名・数量はすべて架空です。紙の印刷やFAX送受信は行わず、画像として作成しました。
2. 原本は3明細でも、候補には2明細しか出なかった
通常画質の注文書Aでは、原本に3明細あるのに、画面に出た候補は2明細でした。数量と単位も確定できませんでした。
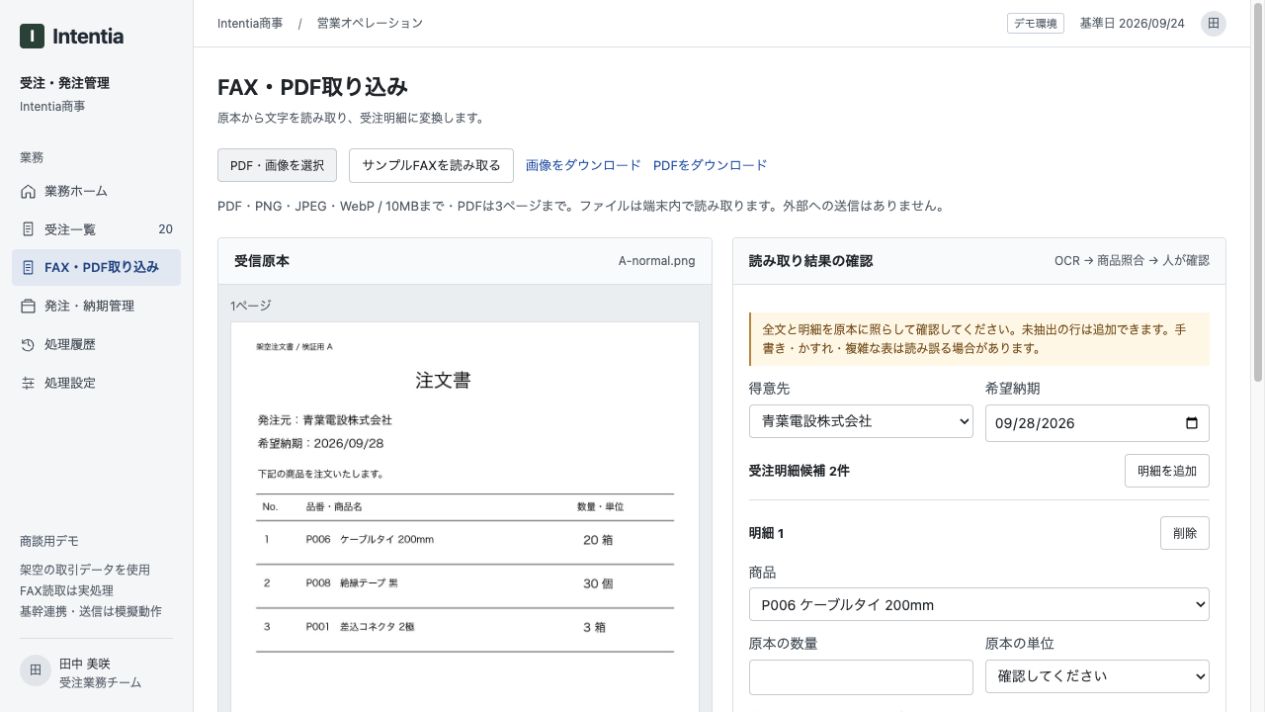
保存したOCR出力では、1行目の「20箱」が「20 #4」、3行目の品番「P001」が「POO]」になっていました。試作の抽出処理は品番を手がかりに明細を切り出すため、品番が崩れると、行の区切りにも影響します。
今回の失敗は、読めた文字を修正するだけの問題ではありません。候補として表示されなかった明細があるため、画面に出た項目だけを確認しても不足します。原本と見比べて、明細数まで確かめる必要がありました。
一方、1明細の注文書Bでは、ケーブルタイの「7箱」を抽出し、商品マスターの入数10個を使って「70個」と表示できました。
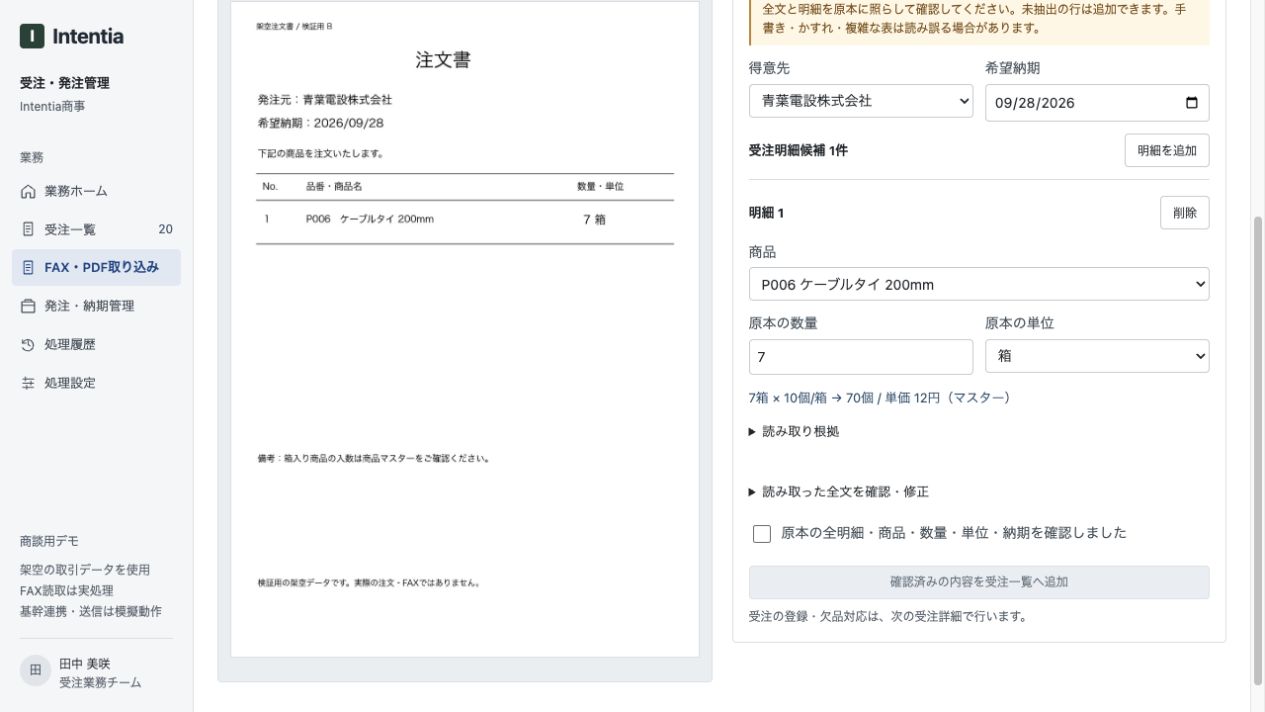
この画面は確認前の候補です。受注登録まで自動で完了した例ではありません。
3. 画像条件を変えた20入力の結果
5枚は同じ書式で、商品・数量・単位・明細数を変えました。各画像について、通常、低解像度、傾き、低コントラストの4条件を試しました。
| 画像条件 | 今回の設定 | 全項目が一致した入力 |
|---|---|---|
| 通常 | 1,500×2,100ピクセル | 2 / 5 |
| 低解像度 | 429×600ピクセルに縮小 | 0 / 5 |
| 傾き | 通常画像を3度回転 | 3 / 5 |
| 低コントラスト | 画像処理のコントラスト係数0.25 | 2 / 5 |
| 合計 | 5枚×4条件 | 7 / 20 |
「全項目が一致」は、得意先・希望納期・明細数に加え、明細の順序も含めて品番・数量・単位・換算後数量が事前に用意した正解と一致した場合です。読み取り後に手で直した値は含めていません。商品名の全文や書類内の全文字が正しいことを示す指標でもありません。
傾けた条件で通常より一致数が多かったものの、この結果だけで「傾けたほうがよい」とは言えません。書式は一つで、元の注文書も5枚です。得意先ごとに異なる帳票で使えるかどうかは、別の検証が必要です。
MicrosoftのOCR技術資料でも、画質や回転などが結果に影響し、利用する文書で評価する必要があると説明されています。今回のデモは同社製品を使ったものではありませんが、入力条件を明示して確かめるという考え方は参考になります。
4. 受注登録の前に、何を見るか
今回の結果から、まず確認したいのは次の4点です。
- 明細数:原本の行が候補から抜けていないか。
- 品番:読み違いや未確定の商品がないか。
- 数量・単位:「箱」と「個」を取り違えていないか。
- 換算の根拠:どの商品の、どの入数を参照したか。
実務では、これに価格・在庫・納期などの確認が加わります。今回の試験は、それらを含む受注業務全体を検証したものではありません。
試作では、担当者が原本を確認してから候補を受注一覧に追加する流れにしています。ただし、確認欄にチェックを付けるだけで読み間違いがなくなるわけではありません。原本と結果を見比べやすくし、抜けた明細を追加できることも必要です。
今回分かったことと、次に確かめること
今回の試作では、数量換算までできる入力がある一方で、通常画質でも明細を取りこぼしました。この結果のまま、確認なしで受注登録する使い方は勧められません。
次は品番が崩れた場合の明細抽出を改善し、今回の20入力で再確認したうえで、別の書式や未使用の帳票でも検証します。同じサンプルだけで結果が良くなっても、実務への対応が確認できたことにはならないためです。
受注入力を減らす取り組みでは、読み取り結果だけでなく、担当者が何を確認し、どこを修正するかまで含めて試す必要があります。
検証条件
- 印字された架空のPNG画像のみ。手書き・実FAX・実顧客データ・PDFは今回の対象外。
- Tesseract.js 6.0.1と、デモに同梱した日本語・英語辞書を使用。生成AIによる帳票理解の評価ではありません。
- 20入力はNode.jsからOCRを実行し、デモと同じ抽出・換算関数で集計。各入力につきワーカーを作成し、修正・再試行なしの1回で評価。
- ブラウザのデモ画面ではA・Bの通常画像を追加確認。20入力すべてをブラウザで検証したわけではありません。
- 数量換算の関数は集計用に呼び出したもの。人による承認や基幹システムへの登録は行っていません。
- 元画像5枚を加工した20入力であり、20種類の独立した帳票ではありません。処理時間・費用・実務での削減効果は比較していません。